GPU RESOURCE MANAGEMENT & AI PLATFORM

Backslash
AIOps

GPUの申請・承認・共有・回収まで、すべてのプロセスをひとつのプラットフォームで運用します。

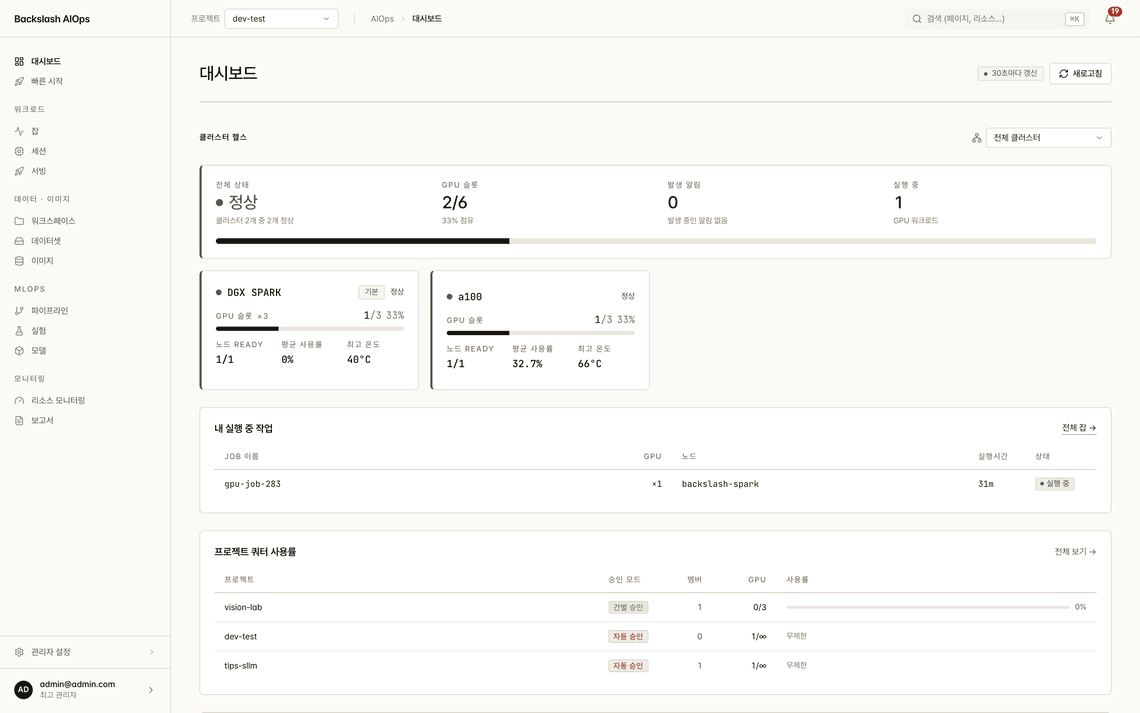
Backslash AIOps 統合ダッシュボード画面

AIOpsが必要な理由

GPUは余っているのに使えない — その問題を解決します。

高価なGPUを遊ばせず、特定のチームに独占させず、インターネットのない環境でも同じように — 実際の運用でぶつかる課題を基準に作りました。

  1. 高価なGPUが遊んでいる

    使い終わったGPUが返却されず、占有されたまま残ります。Backslash AIOpsは期限を過ぎたリソースを自動回収し、放置されたセッションはTTL期限切れで整理します。

  2. 1枚のGPUを1人が丸ごと使っている

    小さな実験でもGPUが1枚まるごと占有されます。Time-slicing・MPS・MIGで1枚を複数人で共有し、HAMi vGPUでメモリと演算リソースを分離して割り当てます。

  3. 特定のチームがGPUを独占している

    先に確保したチームが使い続け、他のチームは待つだけです。組織・プロジェクト・メンバーの3階層クォータでGPU数・同時実行数・月間GPU時間を制限し、FAIR・DRFポリシーで公平に配分します。

  4. リソースが足りないと申請が却下される

    却下された作業は人が申請し直す必要があります。リソースが不足しても却下せず待機キュー(QUEUED)に入れ、空きが出ればポリシーに従って自動実行します。

  5. 誰がいつどれだけ使ったか残らない

    承認や利用の記録がメッセンジャーやExcelに散らばります。申請から回収までをGPURequest CRDと監査ログに残し、利用実績をPDF・Excel・CSV・JSONのレポートで出力します。

  6. 閉域網のため導入が難しい

    インターネットのない環境では、インストールの段階でつまずきます。インストールスクリプト・イメージバンドル・CLIをプラットフォームが直接提供し、1行のコマンドでノードとクラスターを登録します。

Backslash AIOpsは、Kubernetes上でGPUリソースの申請・承認・分割・回収を管理し、その上で学習からサービングまでAIライフサイクル全体を運用するプラットフォームです。

製品概要

申請から回収まで、ひとつの流れで

GPUを申請し、承認を得て使い、返却するまでのすべてがひとつのプラットフォームでつながります。承認履歴と利用実績が途切れずに残ります。

  1. 1

    リソース申請

    理由と期間を添えてGPUを申請

  2. 2

    承認・割り当て

    管理者の承認またはプロジェクトの自動承認

  3. 3

    開発・学習

    セッション・ジョブ・パイプラインでモデルを作る

  4. 4

    モデル・デプロイ

    承認されたモデルだけを推論サービスへ

  5. 5

    モニタリング

    使用率・温度・占有を実測で観測

  6. 6

    回収・精算

    期限が来たら回収し、実績をレポートに

特長

Backslash AIOpsが提供する価値

  • 01.

    End-to-End GPU Operations

    申請・承認・利用・回収・精算をひとつの体系で

    • 申請 → 承認 → 割り当て → 利用 → 回収 → レポートまで途切れなく連携
    • リソース利用履歴がGPURequest CRDと監査ログの両方に残る
    • 組織・プロジェクト・メンバーの3階層でクォータと権限を割り当て
  • 02.

    Practical GPU Sharing

    1枚のGPUを実際に分け合う技術

    • Time-slicing・MPS・MIGの3つの分割モードを画面で切り替え
    • HAMiベースのvGPUでメモリと演算リソースを分離して割り当て
    • 分割数をノードの実測値から導出し、表示と実態がずれない
  • 03.

    Fair & Non-blocking Scheduling

    却下せずに待ち、自動で実行

    • リソース不足時は却下ではなく待機(QUEUED) — 空きが出れば自動で再スケジュール
    • FIFO・LIFO・FAIR・DRFのポリシーをクラスターごとに選択
    • 分散学習はギャングスケジューリングで必要なPodをまとめて確保
  • 04.

    Air-gapped Ready Operations

    閉域網・マルチクラスターを前提とした運用

    • インターネットのない環境でも1行のコマンドでノード・クラスターを登録
    • インストールスクリプト・イメージバンドル・CLIをプラットフォームが直接提供
    • OIDC SSO・2FA・PAT・監査ログでアクセスを統制し記録

製品アーキテクチャ

リソース管理の上にAIライフサイクルを載せました。

下から上へ — Kubernetesインフラ、その上のGPUリソース管理、さらにその上のMLOpsと実行環境。各レイヤーは独立して拡張でき、閉域網・マルチクラスターを前提に設計しています。

ユーザー

  • AI開発者
  • データアナリスト
  • 運用・管理者
  1. ユーザー・実行環境

    • クイックスタート
    • セッション (JupyterLab)
    • ジョブ・分散学習
    • ワークスペース
  2. MLOpsパイプライン

    • データセット
    • パイプライン (Argo)
    • 実験 (MLflow)
    • モデルレジストリ
    • サービング (KServe)
  3. リソース管理・スケジューリング

    • 申請・承認・回収
    • 待機キューポリシー FIFO/LIFO/FAIR/DRF
    • GPU分割戦略
    • プロジェクトクォータ
    • リソースプリセット
  4. 運用・セキュリティ

    • モニタリング・アラート
    • レポート
    • 監査ログ
    • SSO・2FA・PAT
    • インフラパッケージ
  5. インフラ

    • Kubernetes
    • HAMi vGPU
    • GPU Operator · DCGM
    • Prometheus · Grafana
    • NFS · Object Storage
    • Container Registry

主な機能

GPU運用からMLOpsまで、実際の画面で見る14の機能

リソース運用・管理

運用状況をひとつの画面で

統合ダッシュボード

  • クラスター・ノード・GPUスロットの占有状況をリアルタイムに集計し、ひとつの画面に表示
  • 実行中の自分のジョブとプロジェクトのクォータ使用率をあわせて確認
  • Readyノード数・平均使用率・最高温度までクラスターカードに要約
  • アラートや承認待ちなど、対応すべき作業へすぐに移動
クラスターの状態、GPUスロット、実行中のジョブ、プロジェクトのクォータ使用率を表示するBackslash AIOpsのダッシュボード123
  1. 1クラスター別 GPUスロット・ノード状態
  2. 2いま動いている自分のジョブ
  3. 3プロジェクト別クォータ消化率

リソース運用・管理

申請・承認・回収まで

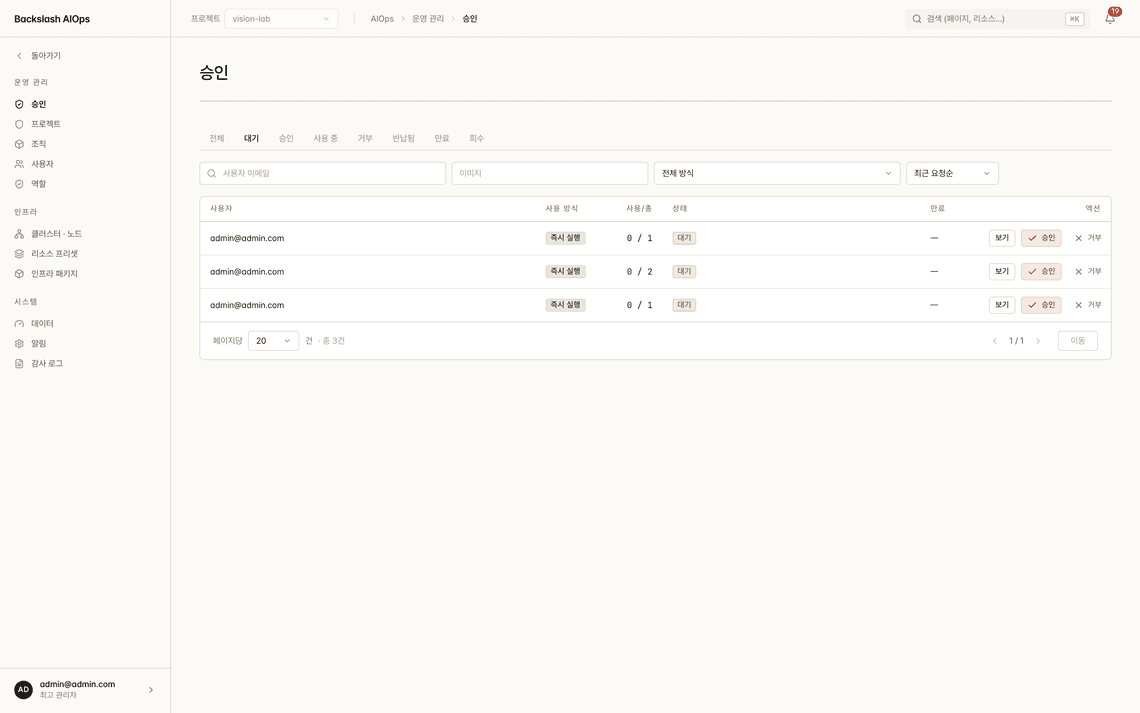
GPU申請ワークフロー

  • ユーザーが理由と期間を記入して申請し、管理者が承認/却下
  • プロジェクトごとの自動承認設定で、繰り返しの承認作業をなくす
  • 期限を過ぎたリソースは自動回収 — 占有されたまま放置されない
  • すべての申請・承認・回収をGPURequest CRDとして記録
GPU申請の一覧と承認状況を表示するBackslash AIOpsの承認画面1
  1. 1承認待ちの申請だけを表示

リソース運用・管理

1枚のGPUを複数人で共有

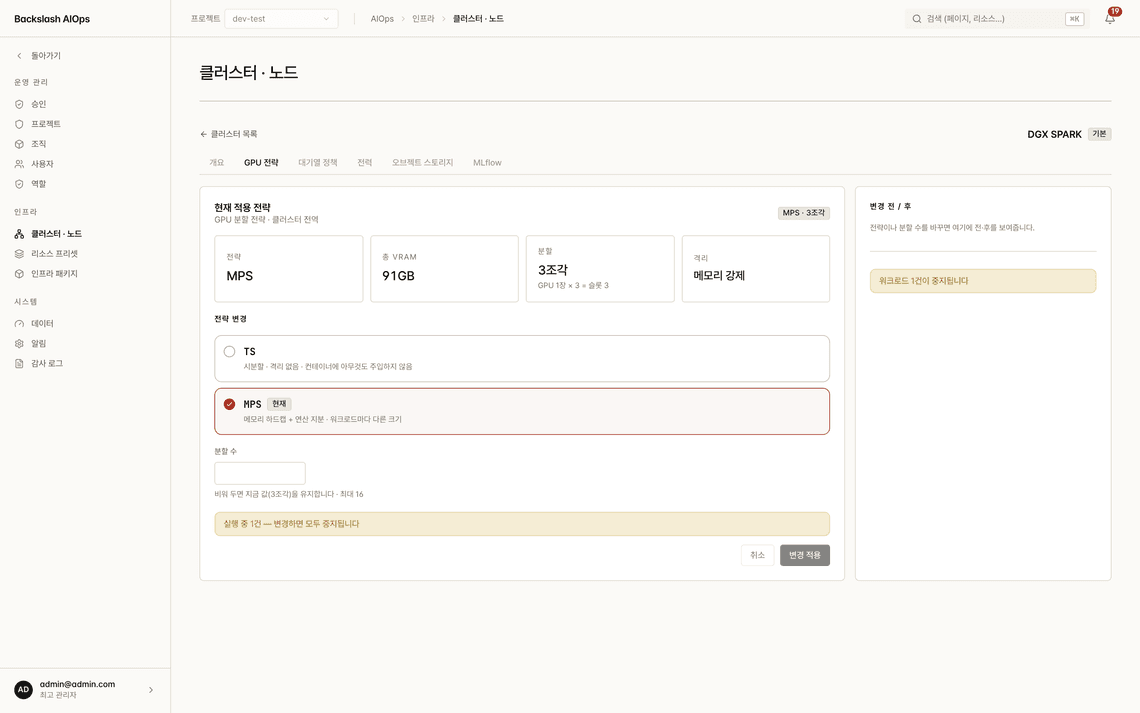
GPU分割戦略

  • Time-slicing・MPS・MIGの3つの分割モードを画面上で切り替え
  • 現在の分割数は設定値ではなくノードの実測値から導出し、常に実態と一致
  • 切り替えに必要なドレイン・再起動の手順をプラットフォームが段階的に実行
  • HAMiベースのvGPUでGPUメモリと演算リソースの割り当てを分離
ノードごとのGPU分割モードを切り替えるBackslash AIOpsのGPU分割戦略画面1
  1. 1Time-slicing・MPS・MIG の切り替え

リソース運用・管理

リソース不足で止まるプロジェクトをなくす

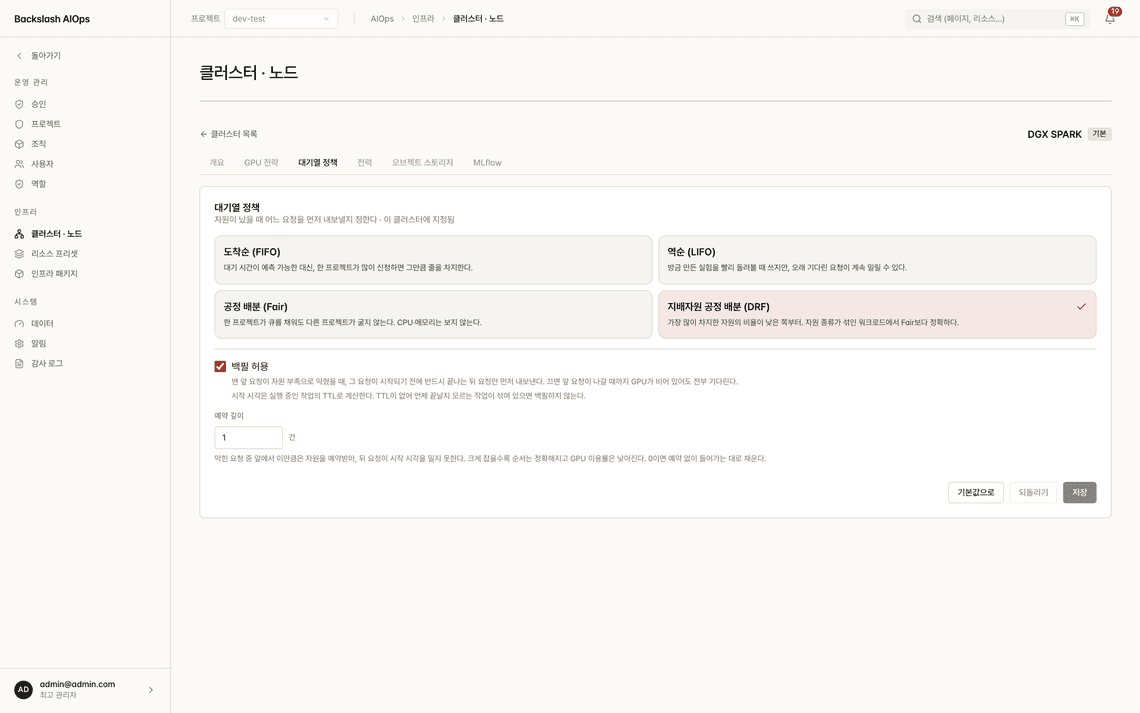
待機キューポリシーと自動再スケジュール

  • リソースが不足しても却下せず待機(QUEUED) — 空きが出れば自動実行
  • FIFO・LIFO・FAIR・DRFの4つのポリシーをクラスターごとに選択
  • 公平性の単位はプロジェクト — クォータ・会計の単位と一致
  • DRFはGPU・CPU・メモリをあわせて評価し、混在ワークロードでも正確
クラスターごとに待機キューポリシーを選択するBackslash AIOpsのスケジューリング設定画面1
  1. 1FIFO・LIFO・FAIR・DRF を選択

リソース運用・管理

組織・プロジェクト単位の

クォータと権限管理

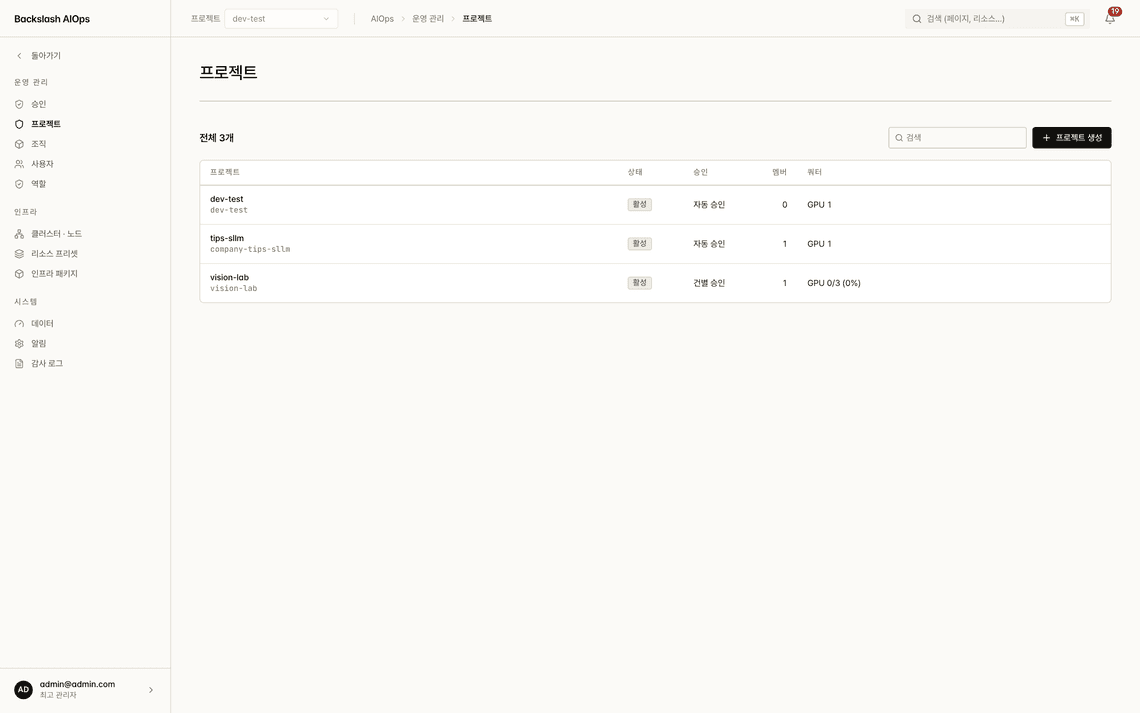
  • 組織 → プロジェクト → メンバーの3階層でリソースを割り当て
  • GPU数・同時実行数・月間GPU時間をプロジェクトごとに制限
  • クォータ使用量はCRDカウントで集計 — 分割GPUでも正確
  • 管理者が定義したリソースプリセットをユーザーが選んで利用
プロジェクトごとのGPU上限と承認モードを表示するBackslash AIOpsのプロジェクト管理画面12
  1. 1プロジェクトごとにGPU上限を設定
  2. 2手動承認プロジェクト

開発・実行環境

ジョブ・セッション・サービングをひとつの流れで

クイックスタート

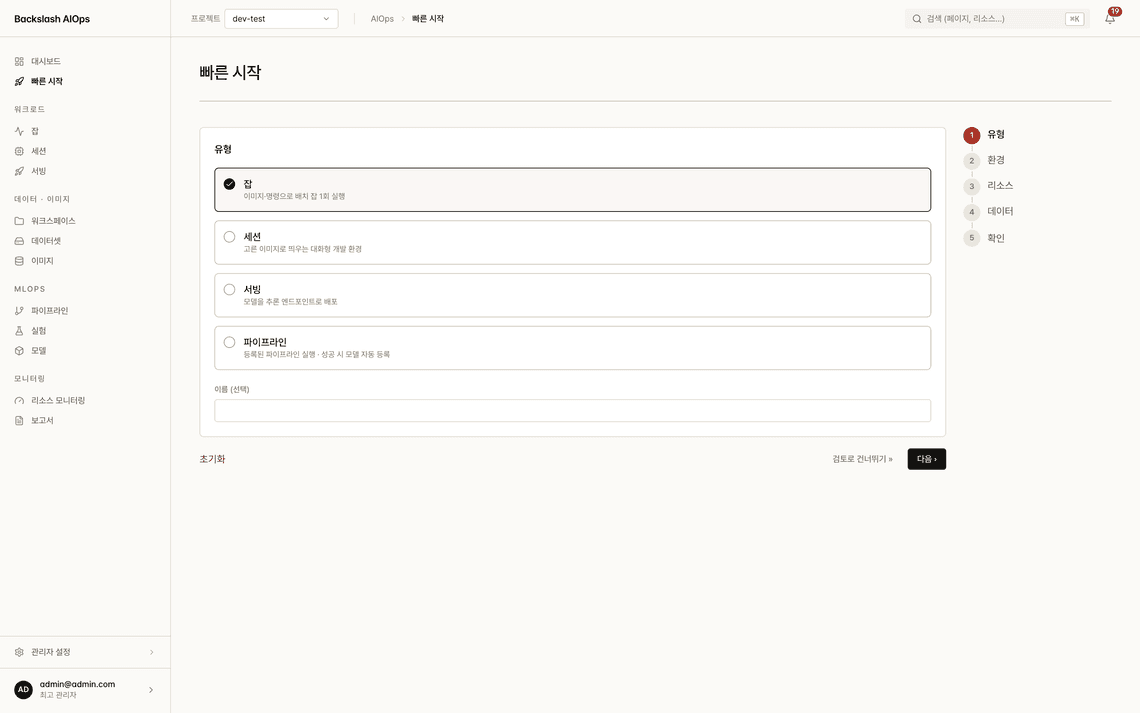
  • 学習ジョブ、ノートブックセッション、モデルサービング、パイプラインをひとつの入口から実行
  • 種類 → 環境 → リソース → データ → 確認の5ステップで実行まで
  • イメージ・データセット・リソースを選べば、残りはプラットフォームが構成
  • 過去の実行をそのまま再実行 — 設定を復元して再現
実行の種類と手順を選ぶBackslash AIOpsのクイックスタート画面12
  1. 1ジョブ・セッション・サービング・パイプライン
  2. 25ステップで実行まで

開発・実行環境

学習ジョブの投入と追跡

ジョブ・分散学習

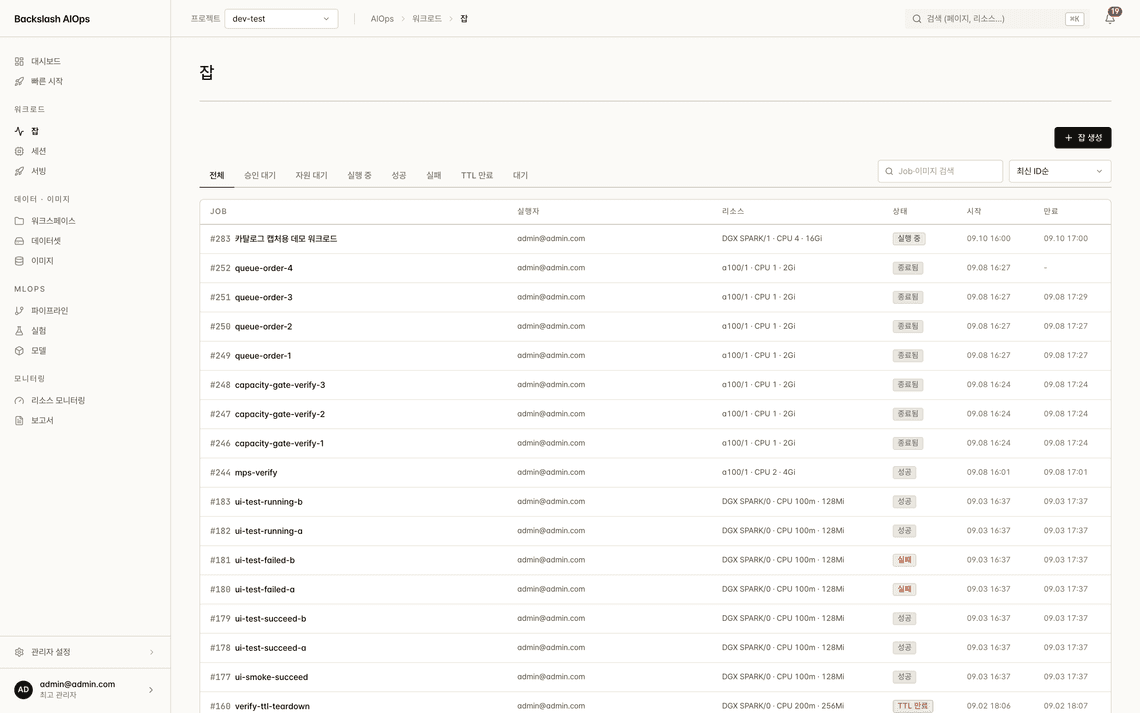
  • 単一ノードの学習と複数Podによる分散学習を同じ画面から投入
  • ギャングスケジューリング — 必要なPodがすべて確保されたときに一斉に開始
  • ランクごとのログを選んで分散学習を追跡
  • リソース待ち・実行中・成功・失敗・TTL期限切れをステータス別に照会
ステータス別の学習ジョブ一覧とリソース占有を表示するBackslash AIOpsのジョブ画面12
  1. 1ステータス別に絞り込み
  2. 2GPU・CPU・メモリの占有

開発・実行環境

すぐに使える開発環境

JupyterLab セッション

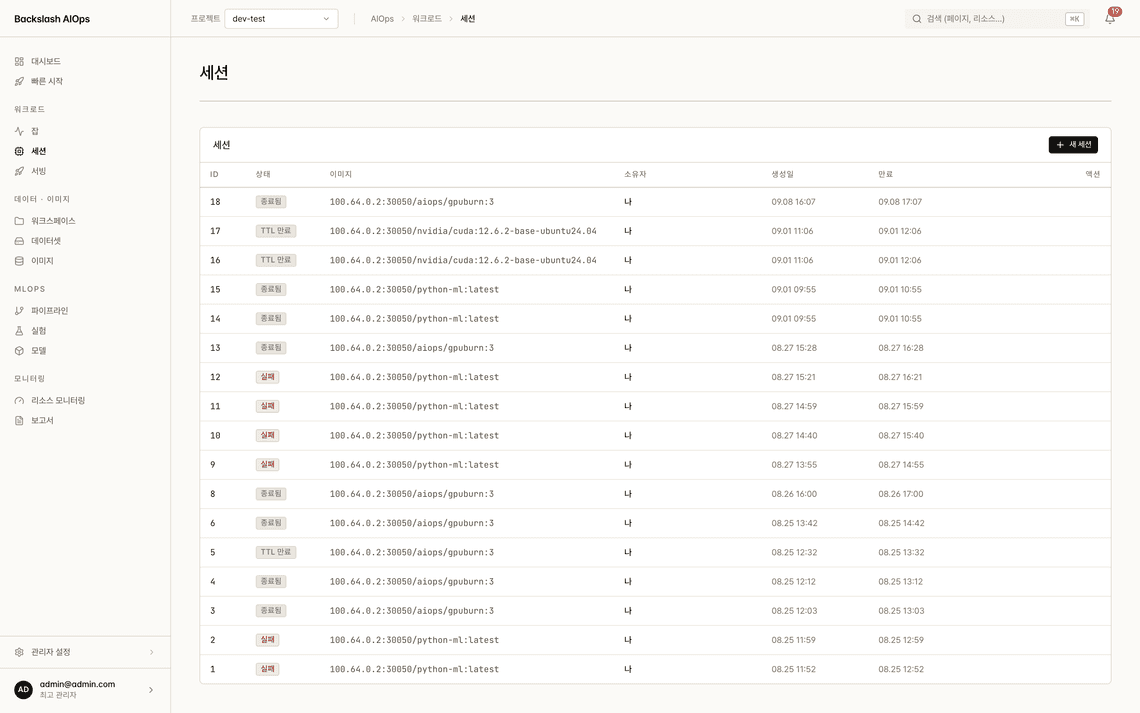
  • 承認済みのGPUでJupyterLab環境を即時起動
  • プラットフォームのプロキシ経由で接続 — ノードのポートを開放しない
  • ワークスペース・データセットをセッションに自動マウント
  • TTL期限切れで放置されたセッションを自動整理し、リソースの無駄を防止
JupyterLabセッションの一覧と有効期限を表示するBackslash AIOpsのセッション画面12
  1. 1承認済みリソースで即時起動
  2. 2期限を過ぎると自動回収

データ・イメージ

環境とデータを固定する

イメージ・データセット管理

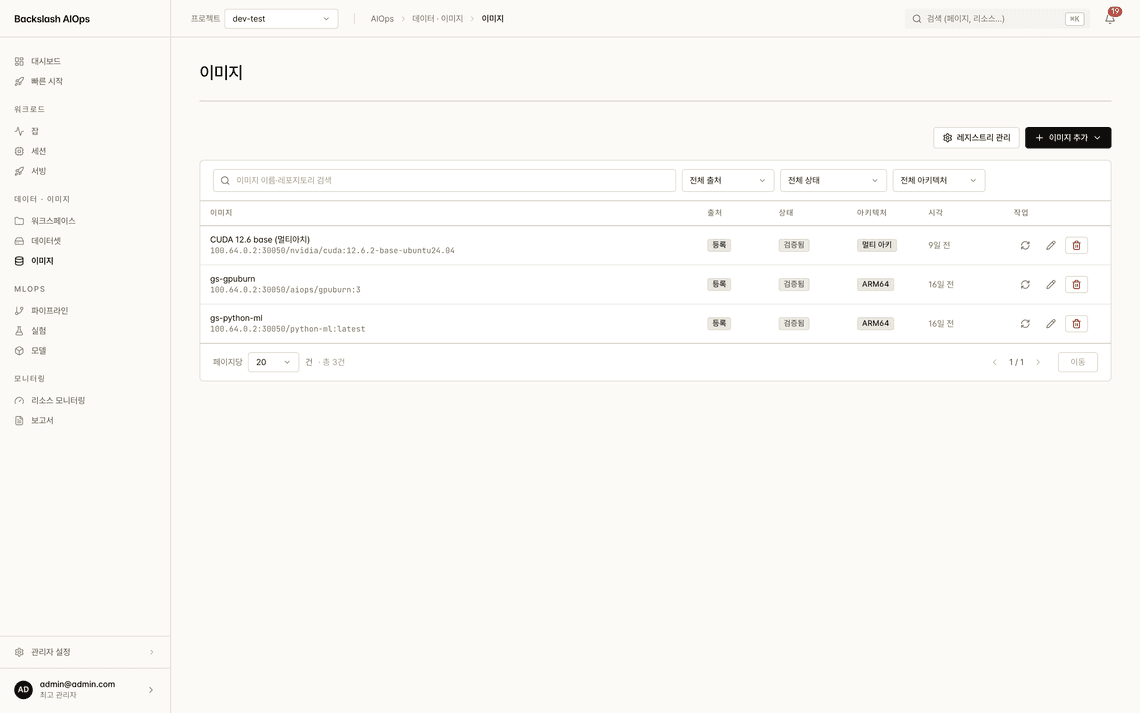
  • プラットフォーム内でコンテナイメージをビルドし、レジストリに登録
  • アーキテクチャ(ARM64・AMD64)を検証し、実行できないイメージを事前に除外
  • データセットは共用・プロジェクト・個人の範囲で共有
  • オブジェクトストレージを接続し、外部データソースをそのまま利用
コンテナイメージとアーキテクチャ検証結果を表示するBackslash AIOpsのイメージ管理画面12
  1. 1プライベートレジストリ接続
  2. 2ARM64・AMD64 検証

MLOps

繰り返し作業を自動化する

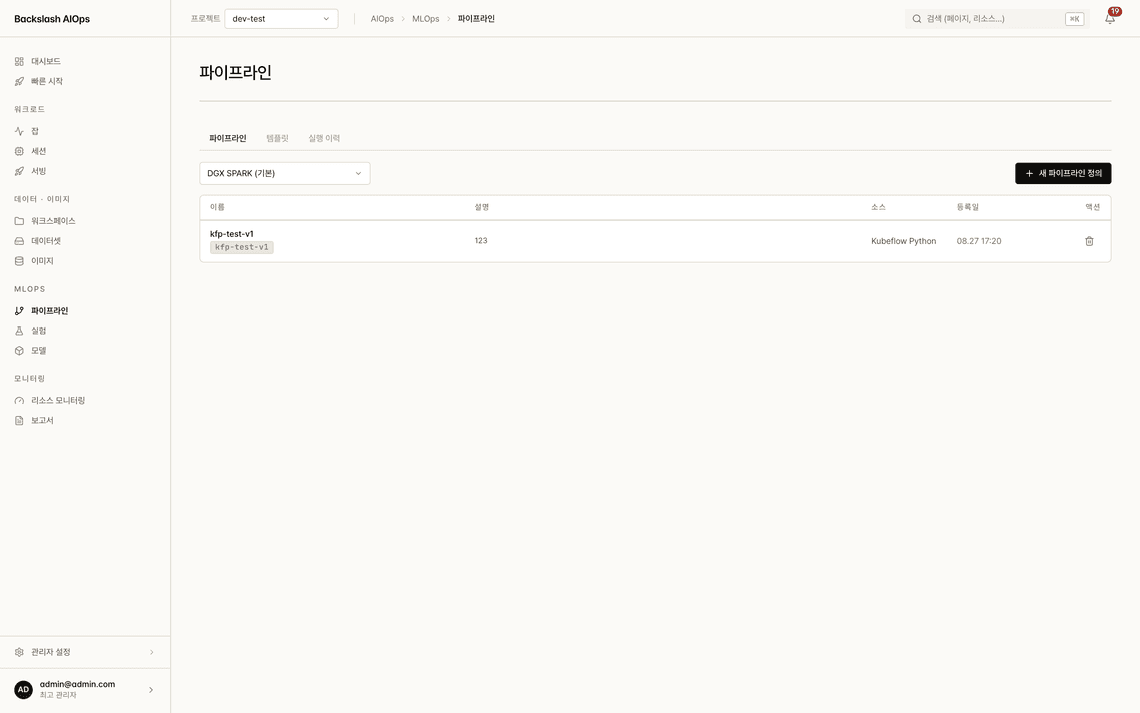
パイプラインと実験管理

  • Argo Workflowsをベースに前処理 → 学習 → 評価 → デプロイを連結
  • Kubeflowパイプラインをコンパイルしてそのまま登録
  • テンプレートとして保存して繰り返し実行 — 実行ごとに履歴が残る
  • MLflowと連携し、メトリクス・パラメータ・アーティファクトを自動記録
パイプラインのテンプレートと実行履歴を表示するBackslash AIOpsのパイプライン画面12
  1. 1実行ごとに履歴が残る
  2. 2Argo・Kubeflow パイプライン

MLOps

承認を経てデプロイされる

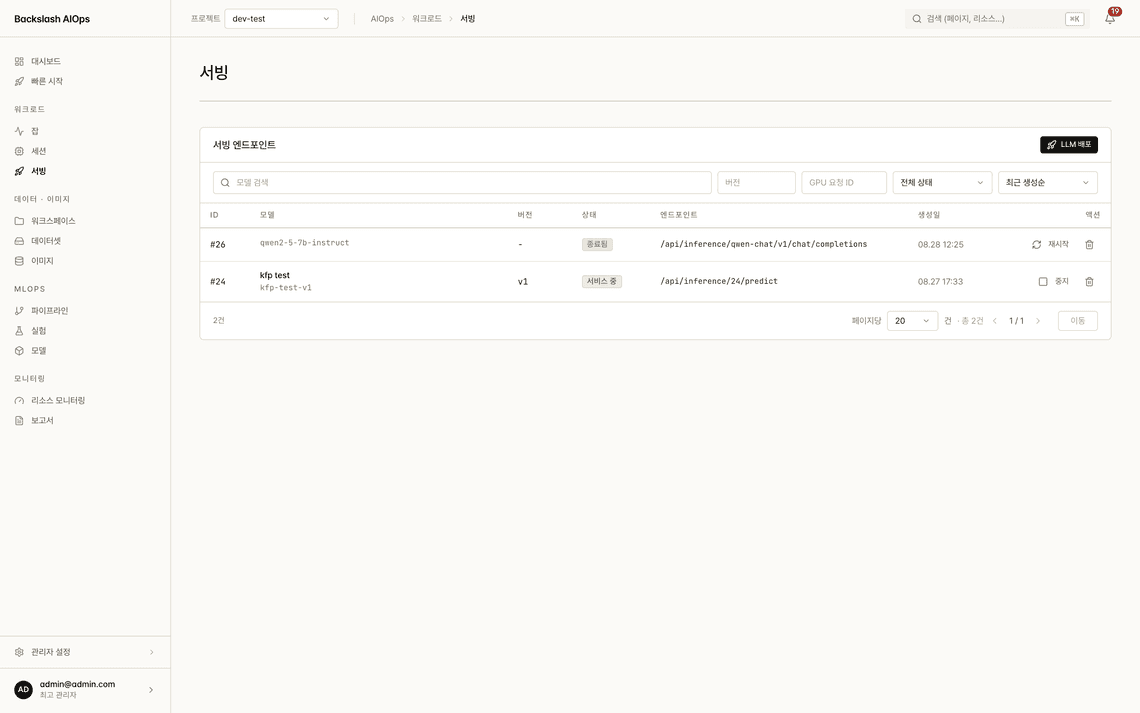
モデルレジストリとサービング

  • 学習が成功するとモデルバージョンが自動登録(レビュー待ち)
  • レビュー待ち → 承認 → デプロイ → 廃棄の単一ゲートのライフサイクル
  • 承認されていないモデルはデプロイできない — プラットフォームが防止
  • KServeへのデプロイと同時にRESTエンドポイントを自動生成
モデルバージョンの状態とサービングのエンドポイントを表示するBackslash AIOpsのモデル画面12
  1. 1RESTエンドポイントを自動生成
  2. 2KServe でワンクリックデプロイ

モニタリング・運用

リソースとワークロードをあわせて見る

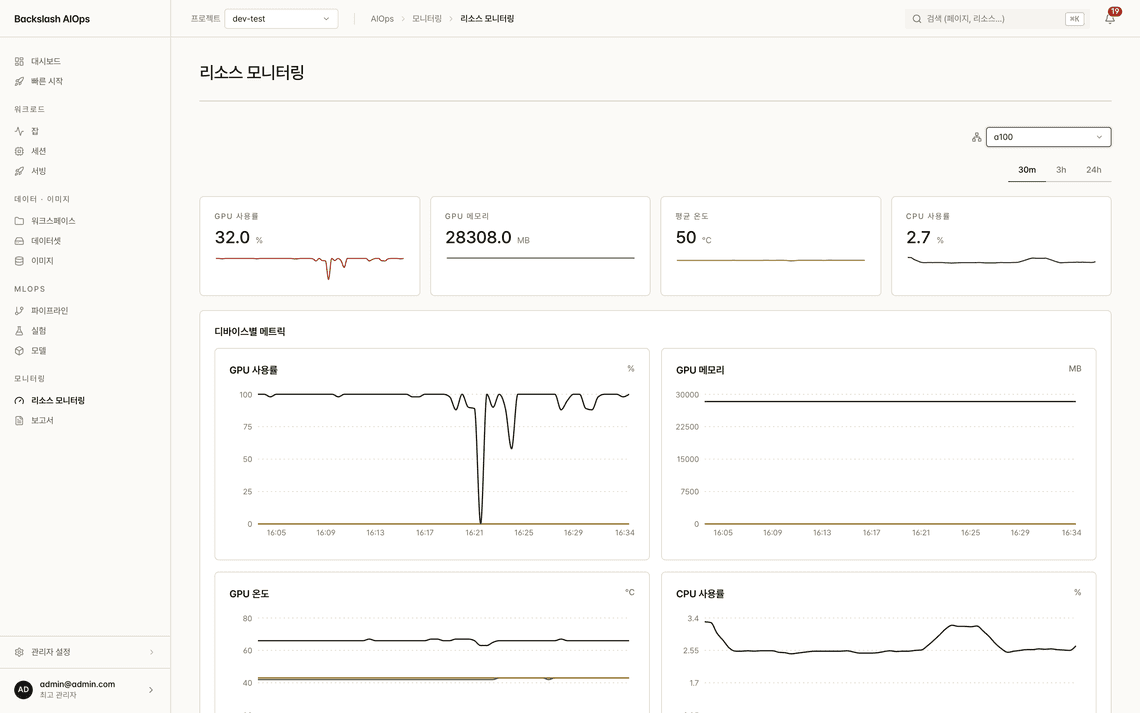
モニタリングとアラート

  • GPU使用率・メモリ・温度をノード単位・ジョブ単位で照会
  • DCGM Exporter・Prometheusベースの実測メトリクス
  • しきい値ベースのアラートルールを画面で定義し、Web・プッシュ・Webhookで通知
  • GPU使用実績をPDF・Excel・CSV・JSONのレポートとしてエクスポート
GPU使用率・メモリ・温度のグラフを表示するBackslash AIOpsのリソースモニタリング画面12
  1. 1DCGM 実測メトリクス
  2. 2ノード・ジョブ単位で照会

インフラ管理

1行のコマンドで接続する

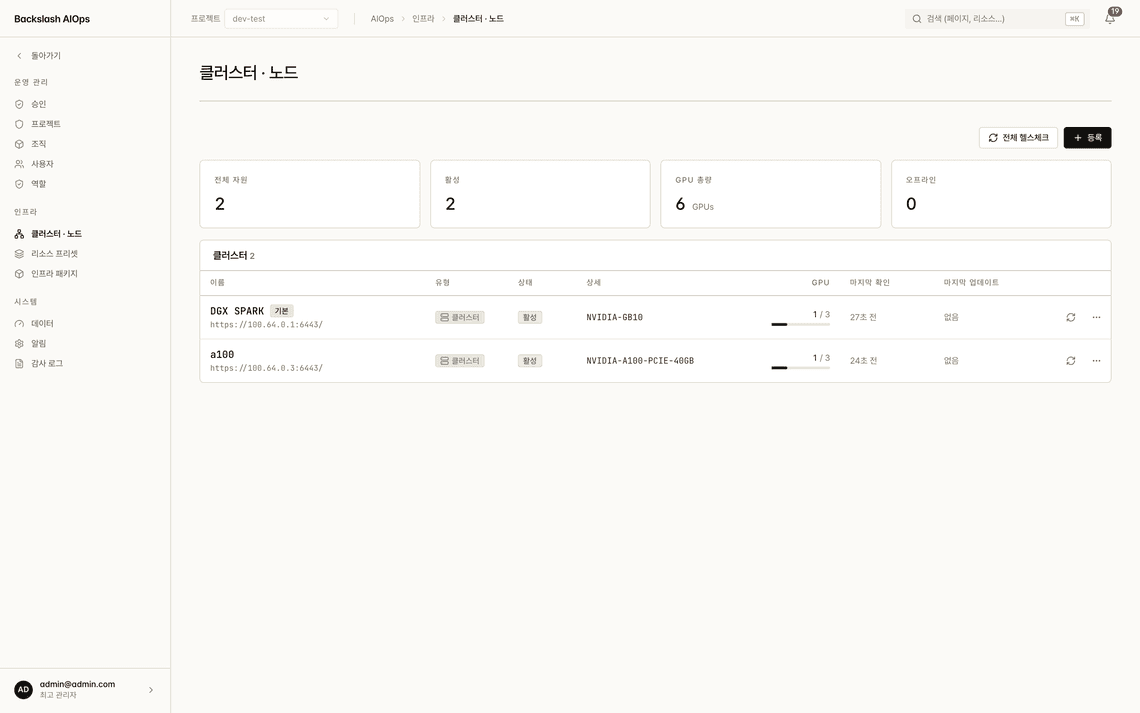
クラスター・ノード登録

  • ウィザードが生成する1行のインストールコマンドでノードを登録
  • リモートクラスターはコネクターエージェントで接続 — 複数クラスターをひとつの画面で
  • 閉域網(Air-gapped)へのインストールに必要なイメージバンドルをプラットフォームが直接提供
  • インフラパッケージのアップグレードとロールバックを画面から実行
登録済みのクラスターとGPUの状況を表示するBackslash AIOpsのクラスター・ノード画面12
  1. 11行のコマンドでノード登録
  2. 2複数クラスターをひとつの画面で

セキュリティ・監査

統制し、記録する

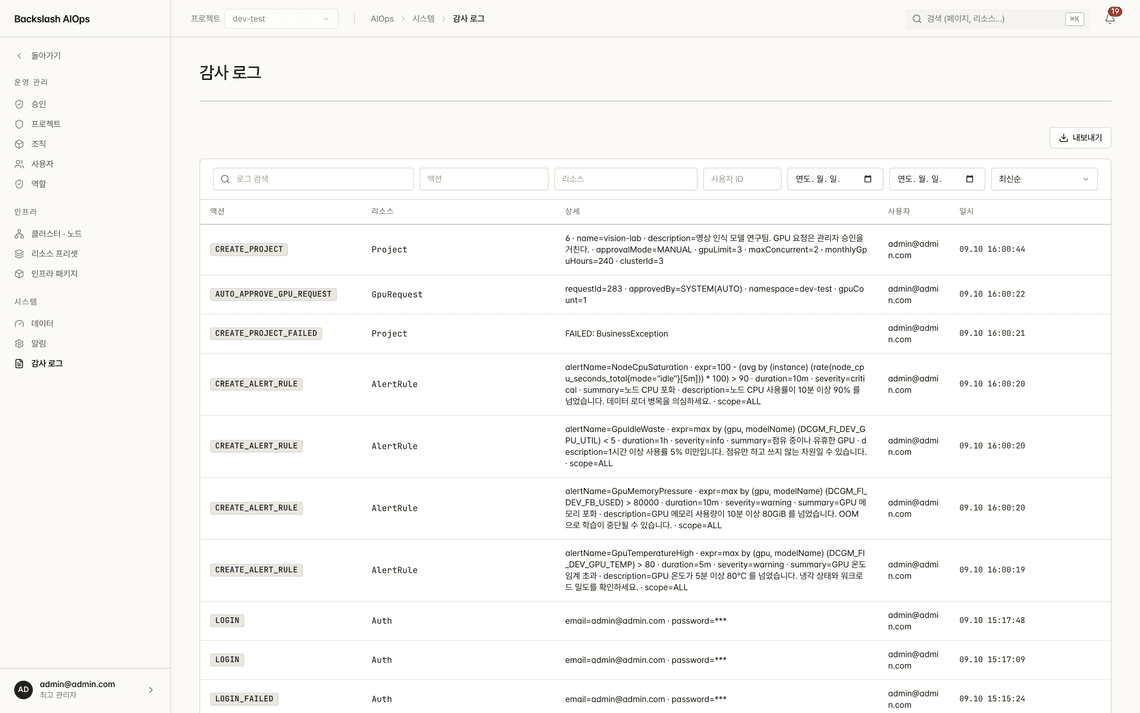
アクセス権限と監査ログ

  • OIDC標準SSO — issuerディスカバリーで社内IdPに接続
  • 2段階認証(TOTP)と自動化用の個人アクセストークン(PAT)に対応
  • ロールごとに権限を細分化し、メニューとAPIへのアクセスをあわせて統制
  • ログイン・リソース申請・承認・設定変更をすべて記録してエクスポート
操作・リソース・ユーザー・日時が記録されたBackslash AIOpsの監査ログ画面12
  1. 1誰が・何を・いつ
  2. 2監査対応用ダウンロード

導入環境

お客様のネットワークと機器を、そのまま受け入れます。

インターネットがなくても、クラスターが複数でも、GPUモデルが異なっていても、同じ方法で運用します。

  1. 01

    オンプレミス

    お客様のデータセンターのGPUサーバーに直接インストール。データが外部に出ることはありません。

  2. 02

    閉域網 (Air-gapped)

    インターネット接続なしでインストール・運用。インストールスクリプトとイメージバンドルをプラットフォームが提供します。

  3. 03

    マルチクラスター

    リモートクラスターをコネクターエージェントで接続し、ひとつの画面でまとめて運用します。

  4. 04

    異種GPU

    A100・H100・H200・B200・B300からDGX Spark(GB10, aarch64)まで、異なるNVIDIA GPU機器を同じ方法で運用します。

実績あるオープンソースの上に構築

  • Kubernetes
  • HAMi vGPU
  • NVIDIA GPU Operator
  • DCGM
  • Argo Workflows
  • KServe
  • MLflow
  • Prometheus · Grafana
  • Spring Boot
  • Next.js

FAQ

よくある質問

Backslash AIOpsとはどのようなソリューションですか?

Backslash AIOpsは、Kubernetes上でGPUリソースの申請・承認・分割・回収を管理し、その上で学習からサービングまでAIライフサイクル全体を運用するプラットフォームです。

1枚のGPUを複数のユーザーで共有できますか?

はい。Time-slicing・MPS・MIGの3つの分割モードを画面で切り替えられ、HAMiベースのvGPUでGPUメモリと演算リソースを分離して割り当てます。分割数は設定値ではなくノードの実測値から導出するため、画面と実態がずれません。

インターネットに接続されていない閉域網にも導入できますか?

はい。インターネット接続なしでインストール・運用できるよう、インストールスクリプトとイメージバンドルをプラットフォームが直接提供し、1行のコマンドでノードとクラスターを登録します。

GPUが不足すると申請は却下されますか?

いいえ。リソースが不足しても申請を却下せず待機(QUEUED)状態にし、空きが出ればクラスターに設定したポリシー(FIFO・LIFO・FAIR・DRF)に従って自動で実行します。

どのようなGPU機器で運用できますか?

A100・H100・H200・B200・B300などのNVIDIA GPUに対応し、DGX Spark(GB10, aarch64)まで異なる機器を同じ方法で運用します。オンプレミスのデータセンターや複数クラスターの環境にも対応します。

Backslash AIOpsの導入をご検討ですか?

保有しているGPU機器とネットワーク環境をお知らせいただければ、導入方法を一緒に検討いたします。

\ BACKSLASH \

代表:ソン・ジュヒョン | 事業者登録番号:787-81-02609
ソウル支社:ソウル特別市衿川区加山デジタル1路120、702号
企業付属研究所:慶尚南道梁山市勿禁邑釜山大学路16、204号
釜山支社:釜山広域市北区ヒョヨルロ76-1、204号
大邱支社:大邱広域市北区チルソンナムロ38ギル56、3階307号
カスタマーサポート:+82 1555-2440(平日10時〜18時)| メール:contact@backslash.co.kr
産業デザイン専門会社届出 第18330号