GPU RESOURCE MANAGEMENT & AI PLATFORM

Backslash
AIOps

GPU를 신청하고, 승인하고, 나눠 쓰고, 회수하는 전 과정을 하나의 플랫폼에서 운영합니다.

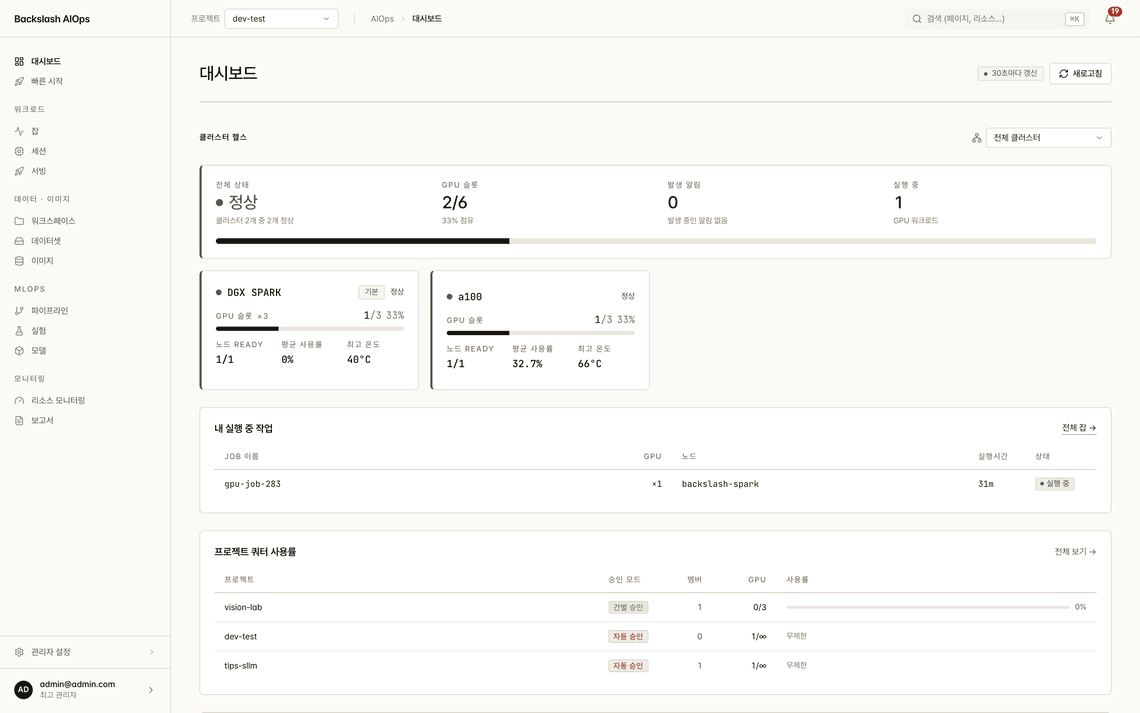
Backslash AIOps 통합 대시보드 화면

AIOps가 필요한 이유

GPU는 남아도는데 못 쓴다 — 그 문제를 풉니다.

비싼 GPU를 놀리지 않고, 특정 팀이 독점하지 않고, 인터넷 없는 망에서도 동일하게 — 실제 운영에서 부딪히는 문제를 기준으로 만들었습니다.

  1. 비싼 GPU가 놀고 있다

    다 쓴 GPU가 반납되지 않고 점유된 채 남습니다. Backslash AIOps는 기한이 지난 자원을 자동 회수하고, 방치된 세션은 TTL 만료로 정리합니다.

  2. GPU 한 장을 한 사람이 통째로 쓴다

    작은 실험에도 GPU 한 장이 통째로 묶입니다. Time-slicing·MPS·MIG로 한 장을 여럿이 나눠 쓰고, HAMi vGPU로 메모리·연산 지분을 분리 할당합니다.

  3. 특정 팀이 GPU를 독점한다

    먼저 잡은 팀이 계속 쓰고 다른 팀은 기다리기만 합니다. 조직·프로젝트·멤버 3단 쿼터로 GPU 수·동시 실행 수·월 GPU 시간을 제한하고, FAIR·DRF 정책으로 공정하게 배분합니다.

  4. 자원이 없으면 요청이 거부된다

    거부된 작업은 사람이 다시 신청해야 합니다. 자원이 부족하면 거부하지 않고 대기열(QUEUED)에 넣고, 자리가 나면 정책에 따라 자동으로 실행합니다.

  5. 누가 언제 얼마나 썼는지 남지 않는다

    승인과 사용 기록이 메신저와 엑셀에 흩어집니다. 신청부터 회수까지 GPURequest CRD와 감사 로그에 남기고, 사용 실적을 PDF·Excel·CSV·JSON 보고서로 내보냅니다.

  6. 폐쇄망이라 도입이 어렵다

    인터넷이 없는 망에서는 설치부터 막힙니다. 설치 스크립트·이미지 번들·CLI를 플랫폼이 직접 공급하고, 한 줄 명령으로 노드와 클러스터를 등록합니다.

Backslash AIOps는 Kubernetes 위에서 GPU 자원의 신청·승인·분할·회수를 관리하고, 그 위에서 학습부터 서빙까지 AI 라이프사이클 전체를 운영하는 플랫폼입니다.

제품 개요

요청부터 회수까지 한 흐름

GPU를 신청하고 승인받아 쓰고 반납하는 과정 전체가 한 플랫폼 안에서 이어집니다. 승인 이력과 사용 실적이 끊기지 않고 남습니다.

  1. 1

    자원 신청

    사용자가 사유·기간과 함께 GPU를 요청

  2. 2

    승인 · 배정

    관리자 승인 또는 프로젝트 자동 승인

  3. 3

    개발 · 학습

    세션·잡·파이프라인으로 모델을 만든다

  4. 4

    모델 · 배포

    승인된 모델만 추론 서비스로 배포

  5. 5

    모니터링

    사용률·온도·점유를 실측으로 관측

  6. 6

    회수 · 정산

    기한이 지나면 회수하고 실적을 보고서로

특장점

Backslash AIOps가 제공하는 가치

  • 01.

    End-to-End GPU Operations

    요청 · 승인 · 사용 · 회수 · 정산의 단일 체계

    • 신청 → 승인 → 배정 → 사용 → 회수 → 보고서까지 끊김 없이 연결
    • 자원 사용 이력이 GPURequest CRD와 감사 로그에 함께 남는다
    • 조직 · 프로젝트 · 멤버 3단 구조로 쿼터와 권한을 나눠 배정
  • 02.

    Practical GPU Sharing

    한 장의 GPU를 실제로 나눠 쓰는 기술

    • Time-slicing · MPS · MIG 세 가지 분할 모드를 화면에서 전환
    • HAMi 기반 vGPU로 메모리·연산 지분을 분리 할당
    • 분할 수를 노드 실측에서 유도해 표시값과 실제가 어긋나지 않는다
  • 03.

    Fair & Non-blocking Scheduling

    거부하지 않고 기다렸다 자동으로 실행

    • 자원 부족 시 거부가 아닌 대기(QUEUED) — 자리가 나면 자동 재스케줄
    • FIFO · LIFO · FAIR · DRF 정책을 클러스터마다 선택
    • 분산 학습은 갱 스케줄링으로 필요한 파드를 함께 확보
  • 04.

    Air-gapped Ready Operations

    폐쇄망·멀티클러스터를 전제로 한 운영

    • 인터넷 없는 망에서도 한 줄 명령으로 노드·클러스터 등록
    • 설치 스크립트·이미지 번들·CLI를 플랫폼이 직접 서빙
    • OIDC SSO · 2FA · PAT · 감사 로그로 접근을 통제하고 기록

제품 아키텍처

자원 관리 위에 AI 라이프사이클을 얹었습니다.

아래에서 위로 — Kubernetes 인프라, 그 위의 GPU 자원 관리, 다시 그 위의 MLOps와 실행 환경. 각 계층은 독립적으로 확장되며 폐쇄망·멀티클러스터를 전제로 설계했습니다.

사용자

  • AI 개발자
  • 데이터 분석가
  • 운영 · 관리자
  1. 사용자 · 실행 환경

    • 빠른 시작
    • 세션 (JupyterLab)
    • 잡 · 분산 학습
    • 워크스페이스
  2. MLOps 파이프라인

    • 데이터셋
    • 파이프라인 (Argo)
    • 실험 (MLflow)
    • 모델 레지스트리
    • 서빙 (KServe)
  3. 자원 관리 · 스케줄링

    • 요청 · 승인 · 회수
    • 대기열 정책 FIFO/LIFO/FAIR/DRF
    • GPU 분할 전략
    • 프로젝트 쿼터
    • 리소스 프리셋
  4. 운영 · 보안

    • 모니터링 · 알림
    • 보고서
    • 감사 로그
    • SSO · 2FA · PAT
    • 인프라 패키지
  5. 인프라

    • Kubernetes
    • HAMi vGPU
    • GPU Operator · DCGM
    • Prometheus · Grafana
    • NFS · Object Storage
    • Container Registry

주요 기능

GPU 운영부터 MLOps까지, 실제 화면으로 보는 14가지 기능

자원 운용 및 관리

운영 상태를 한 화면에서

통합 대시보드

  • 클러스터 · 노드 · GPU 슬롯 점유를 실시간으로 집계해 한 화면에 표시
  • 내 실행 중 작업과 프로젝트 쿼터 사용률을 함께 확인
  • 노드 Ready 수 · 평균 사용률 · 최고 온도까지 클러스터 카드에 요약
  • 알림 · 승인 대기 등 처리할 일로 바로 이동
클러스터 헬스, GPU 슬롯, 실행 중 작업, 프로젝트 쿼터 사용률을 보여주는 Backslash AIOps 대시보드123
  1. 1클러스터별 GPU 슬롯 · 노드 상태
  2. 2지금 돌아가는 내 작업
  3. 3프로젝트별 쿼터 소진율

자원 운용 및 관리

신청 · 승인 · 회수까지

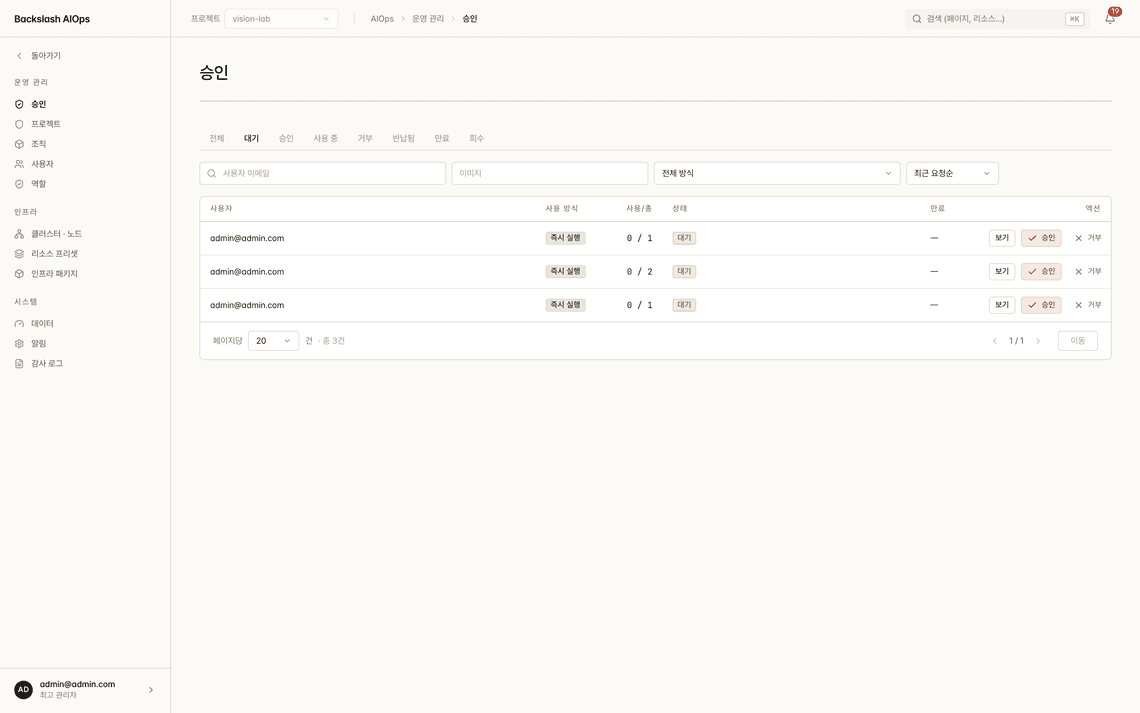
GPU 요청 워크플로우

  • 사용자가 사유 · 기간을 적어 요청하면 관리자가 승인 / 거부
  • 프로젝트별 자동 승인 설정으로 반복 승인 부담을 없앤다
  • 기한이 지난 자원은 자동 회수 — 점유된 채 방치되지 않는다
  • 모든 요청 · 승인 · 회수는 GPURequest CRD로 기록
GPU 요청 목록과 승인 대기 상태를 보여주는 Backslash AIOps 승인 화면1
  1. 1승인 대기 요청만 모아 보기

자원 운용 및 관리

GPU 한 장을 여럿이 나눠 쓰는

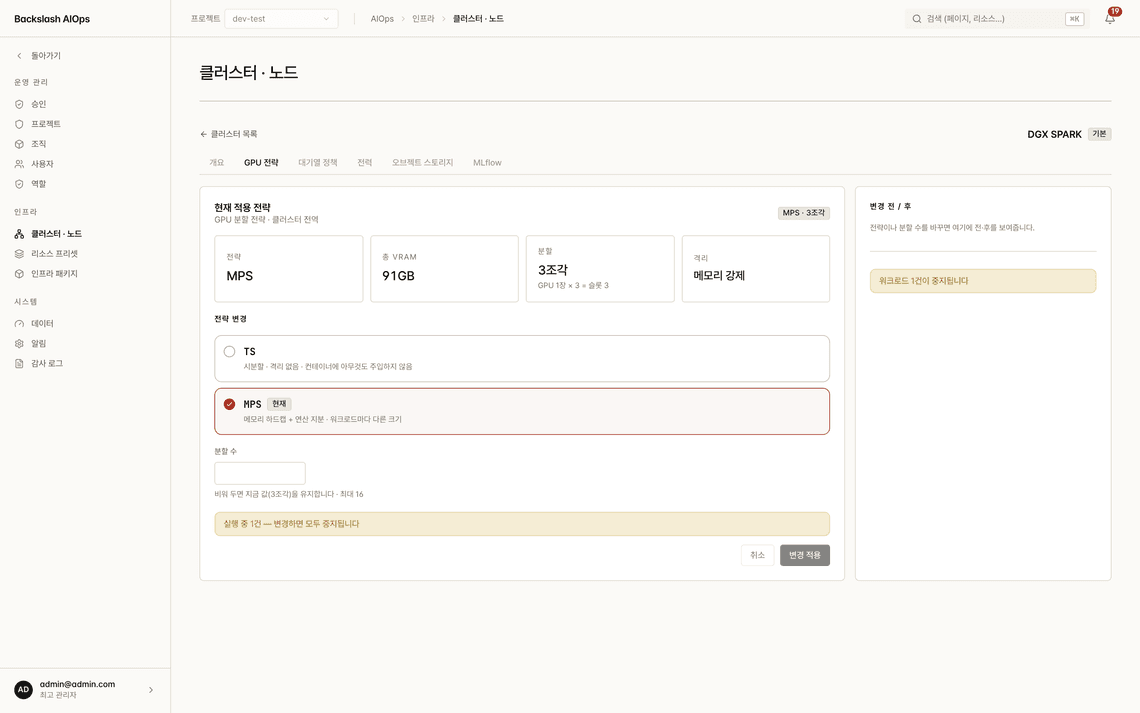
GPU 분할 전략

  • Time-slicing · MPS · MIG 세 가지 분할 모드를 화면에서 전환
  • 현재 분할 수는 설정값이 아니라 노드 실측에서 유도해 항상 실제와 일치
  • 전환에 필요한 드레인 · 재기동 절차를 플랫폼이 단계별로 수행
  • HAMi 기반 vGPU로 GPU 메모리 · 연산 지분을 분리 할당
노드별 GPU 분할 모드를 전환하는 Backslash AIOps GPU 분할 전략 화면1
  1. 1Time-slicing · MPS · MIG 전환

자원 운용 및 관리

굶는 프로젝트가 없도록

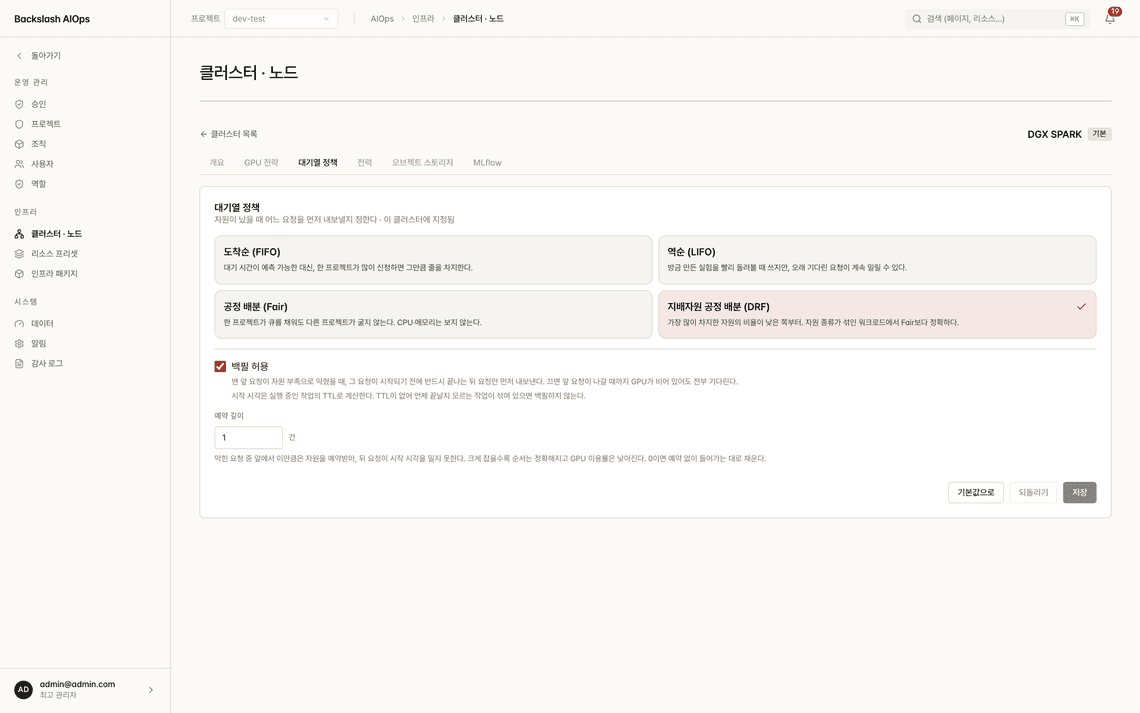
대기열 정책과 자동 재스케줄

  • 자원이 부족하면 거부가 아니라 대기(QUEUED) — 자리가 나면 자동 실행
  • FIFO · LIFO · FAIR · DRF 네 가지 정책을 클러스터마다 선택
  • 공정성 단위는 프로젝트 — 쿼터 · 회계 단위와 일치시킨다
  • DRF는 GPU · CPU · 메모리를 함께 보아 혼합 워크로드에서 정확
클러스터별 대기열 정책을 선택하는 Backslash AIOps 스케줄링 설정 화면1
  1. 1FIFO · LIFO · FAIR · DRF 선택

자원 운용 및 관리

조직 · 프로젝트 단위의

쿼터와 권한 관리

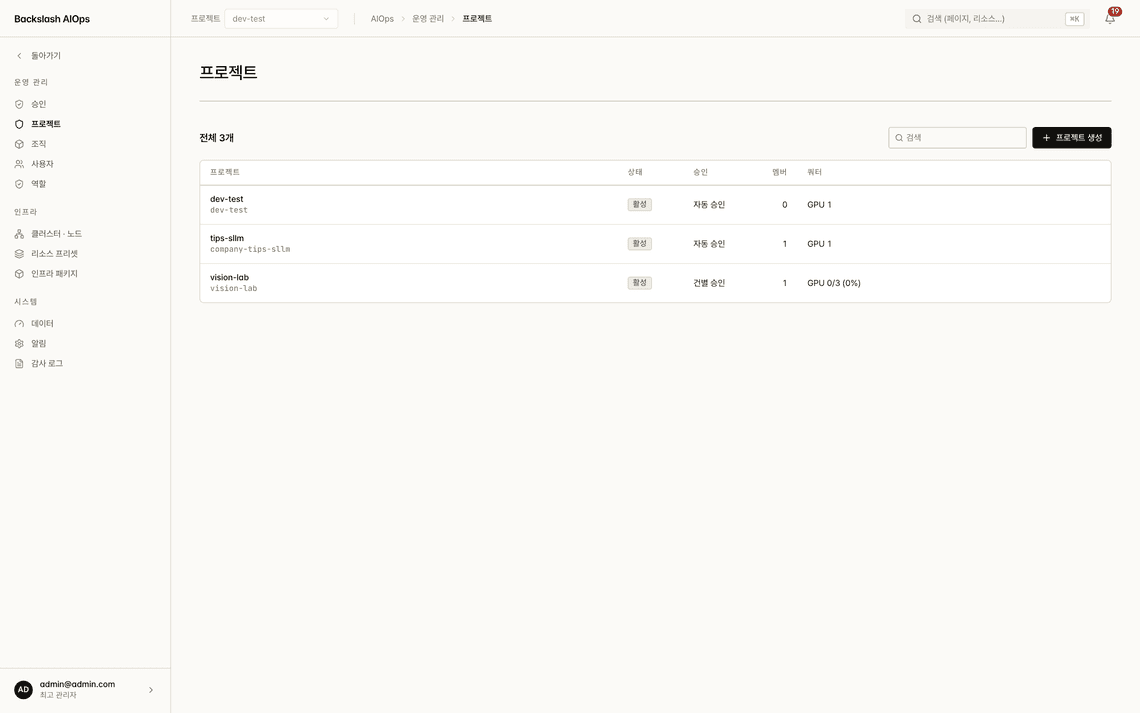
  • 조직 → 프로젝트 → 멤버 3단 구조로 자원을 나눠 배정
  • GPU 수 · 동시 실행 수 · 월 GPU 시간을 프로젝트마다 제한
  • 쿼터 사용량은 CRD 카운팅으로 집계 — 분할 GPU에서도 정확
  • 관리자가 정의한 리소스 프리셋을 사용자가 골라 쓴다
프로젝트별 GPU 한도와 승인 모드를 보여주는 Backslash AIOps 프로젝트 관리 화면12
  1. 1프로젝트마다 GPU 한도를 건다
  2. 2수동 승인 프로젝트

개발 및 실행 환경

잡 · 세션 · 서빙을 한 흐름으로

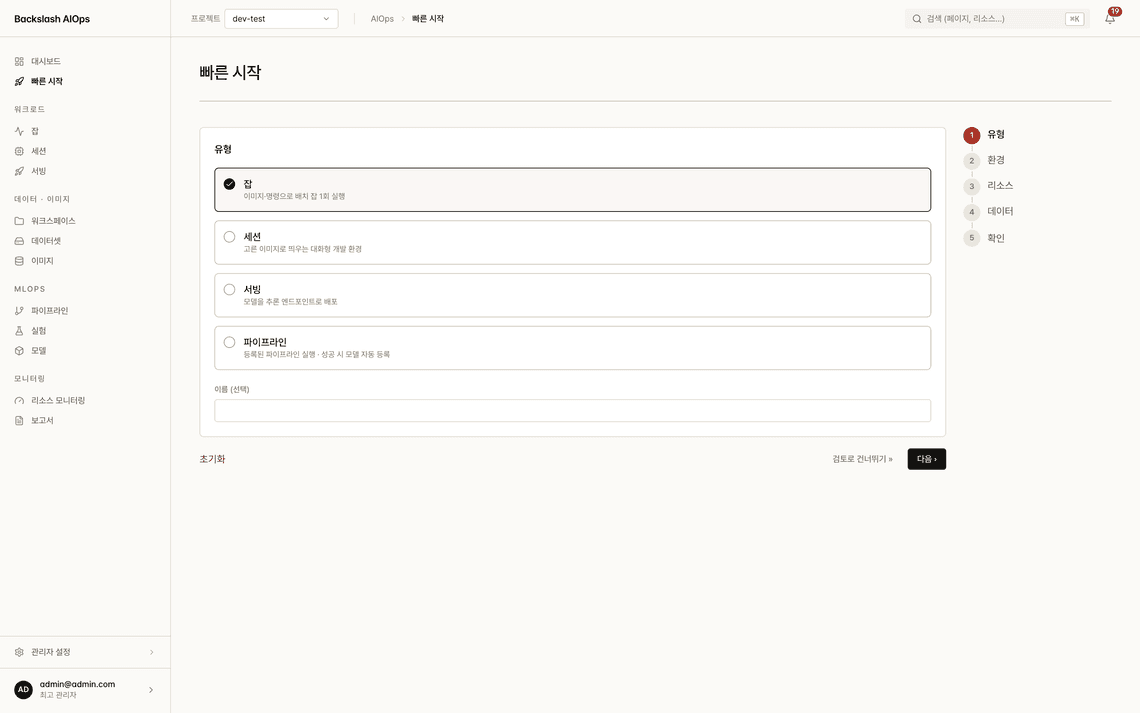
빠른 시작

  • 학습 잡, 노트북 세션, 모델 서빙, 파이프라인을 하나의 진입점에서 실행
  • 유형 → 환경 → 리소스 → 데이터 → 확인, 5단계로 실행까지
  • 이미지 · 데이터셋 · 자원을 고르면 나머지는 플랫폼이 구성
  • 이전 실행을 그대로 다시 실행 — 설정을 복원해 재현한다
실행 유형과 단계를 고르는 Backslash AIOps 빠른 시작 화면12
  1. 1잡 · 세션 · 서빙 · 파이프라인
  2. 25단계로 실행까지

개발 및 실행 환경

학습 작업의 제출과 추적

잡 · 분산 학습

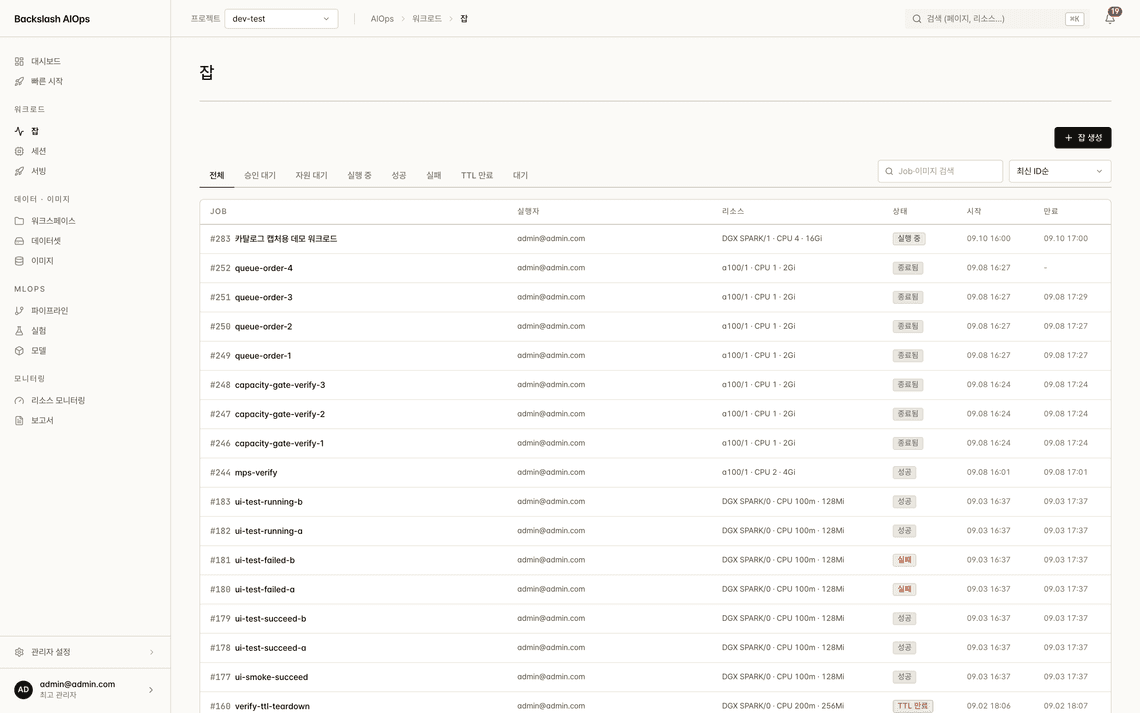
  • 단일 노드 학습과 다중 파드 분산 학습을 같은 화면에서 제출
  • 갱 스케줄링 — 필요한 파드가 모두 확보될 때 함께 시작
  • 랭크별 로그를 골라 보며 분산 학습을 추적
  • 자원 대기 · 실행 중 · 성공 · 실패 · TTL 만료를 상태별로 조회
상태별 학습 잡 목록과 자원 점유를 보여주는 Backslash AIOps 잡 화면12
  1. 1상태별로 걸러 보기
  2. 2GPU · CPU · 메모리 점유

개발 및 실행 환경

즉시 쓰는 개발 환경

JupyterLab 세션

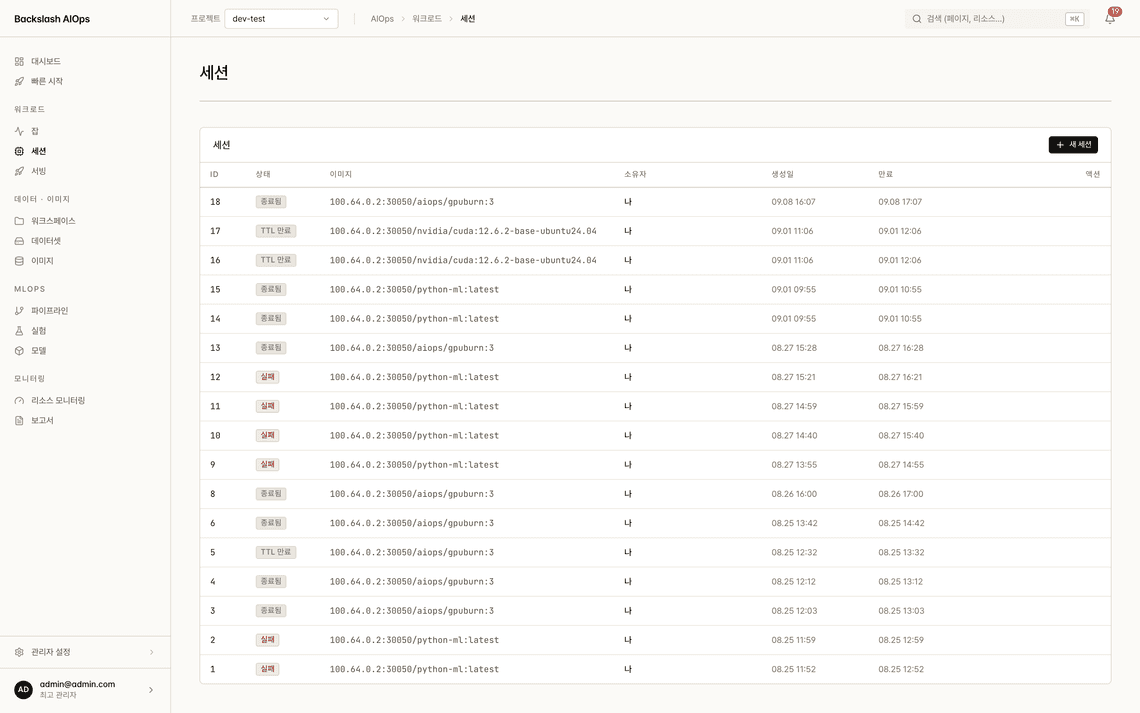
  • 승인받은 GPU로 JupyterLab 환경을 즉시 기동
  • 플랫폼 프록시로 접속 — 노드 포트를 열지 않는다
  • 워크스페이스 · 데이터셋이 세션에 자동 마운트
  • TTL 만료로 방치된 세션을 자동 정리해 자원 낭비를 막는다
JupyterLab 세션 목록과 만료 시각을 보여주는 Backslash AIOps 세션 화면12
  1. 1승인된 자원으로 즉시 기동
  2. 2기한이 지나면 자동 회수

데이터 및 이미지

환경과 데이터를 고정하는

이미지 · 데이터셋 관리

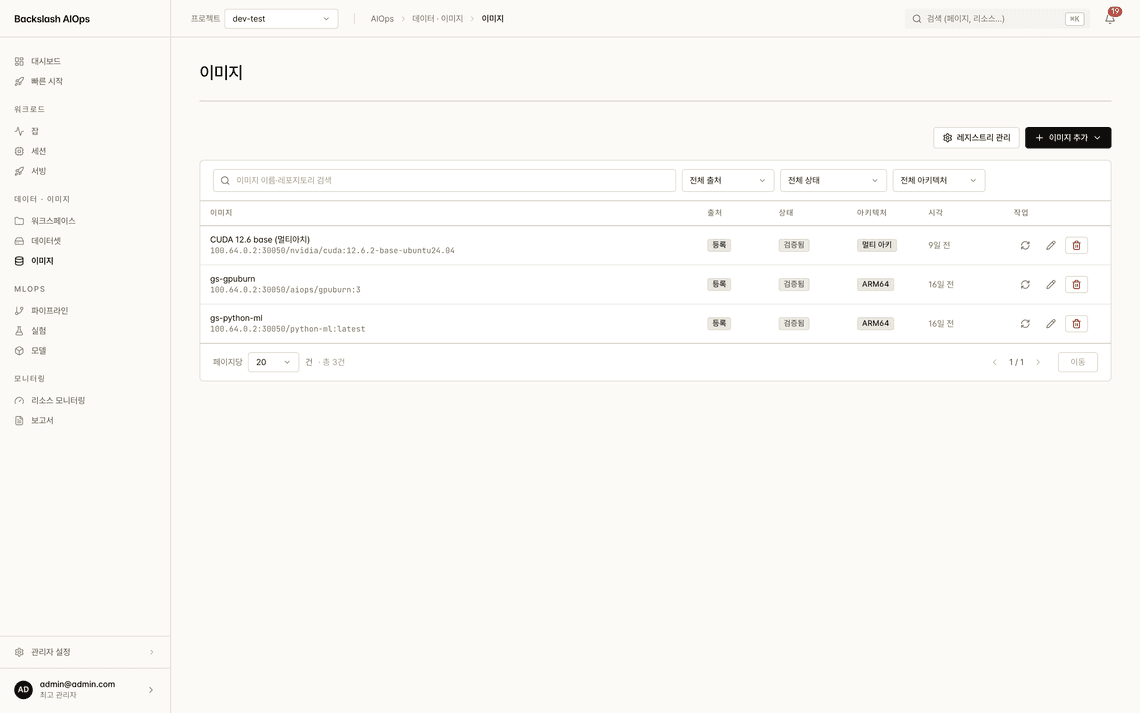
  • 플랫폼 안에서 컨테이너 이미지를 빌드하고 레지스트리에 등록
  • 아키텍처(ARM64 · AMD64)를 검증해 실행 불가 이미지를 미리 걸러낸다
  • 데이터셋은 공용 · 프로젝트 · 개인 범위로 나눠 공유
  • 오브젝트 스토리지를 연결해 외부 데이터 소스를 그대로 사용
컨테이너 이미지와 아키텍처 검증 결과를 보여주는 Backslash AIOps 이미지 관리 화면12
  1. 1사설 레지스트리 연결
  2. 2ARM64 · AMD64 검증

MLOps

반복 작업을 자동화하는

파이프라인과 실험 관리

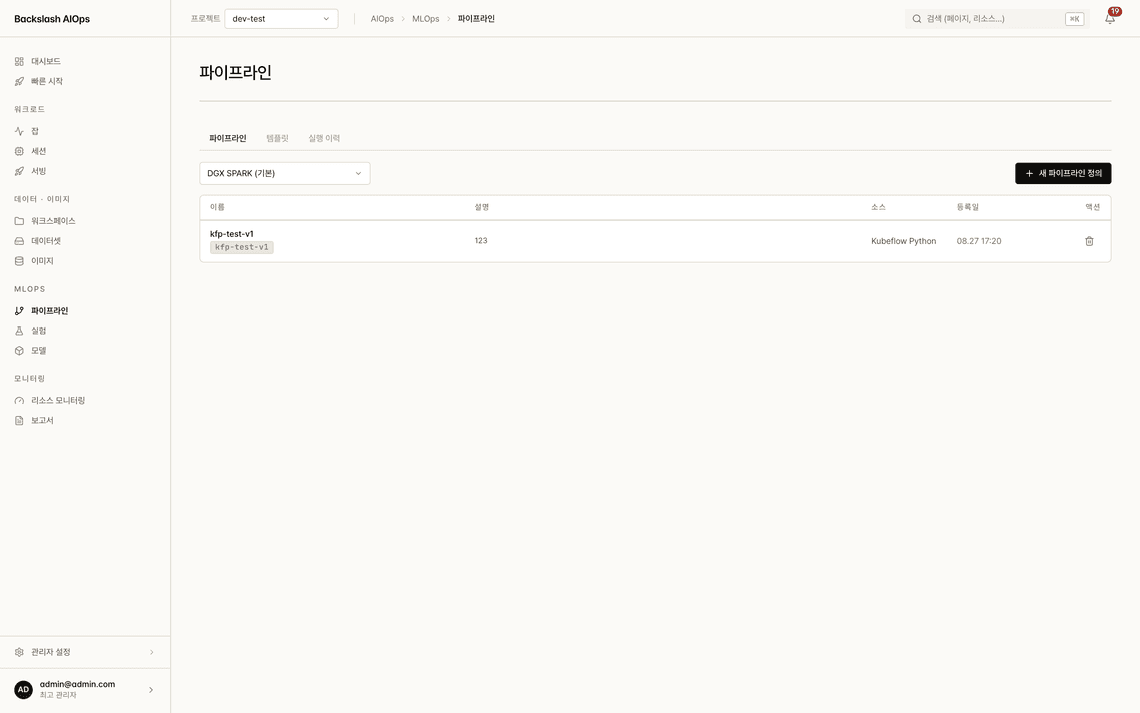
  • Argo Workflows 기반으로 전처리 → 학습 → 평가 → 배포를 연결
  • Kubeflow 파이프라인을 컴파일해 그대로 등록
  • 템플릿으로 저장해 반복 실행 — 실행마다 이력이 남는다
  • MLflow와 연동해 지표 · 파라미터 · 아티팩트를 자동 기록
파이프라인 템플릿과 실행 이력을 보여주는 Backslash AIOps 파이프라인 화면12
  1. 1실행마다 이력이 남는다
  2. 2Argo · Kubeflow 파이프라인

MLOps

승인을 거쳐 배포되는

모델 레지스트리와 서빙

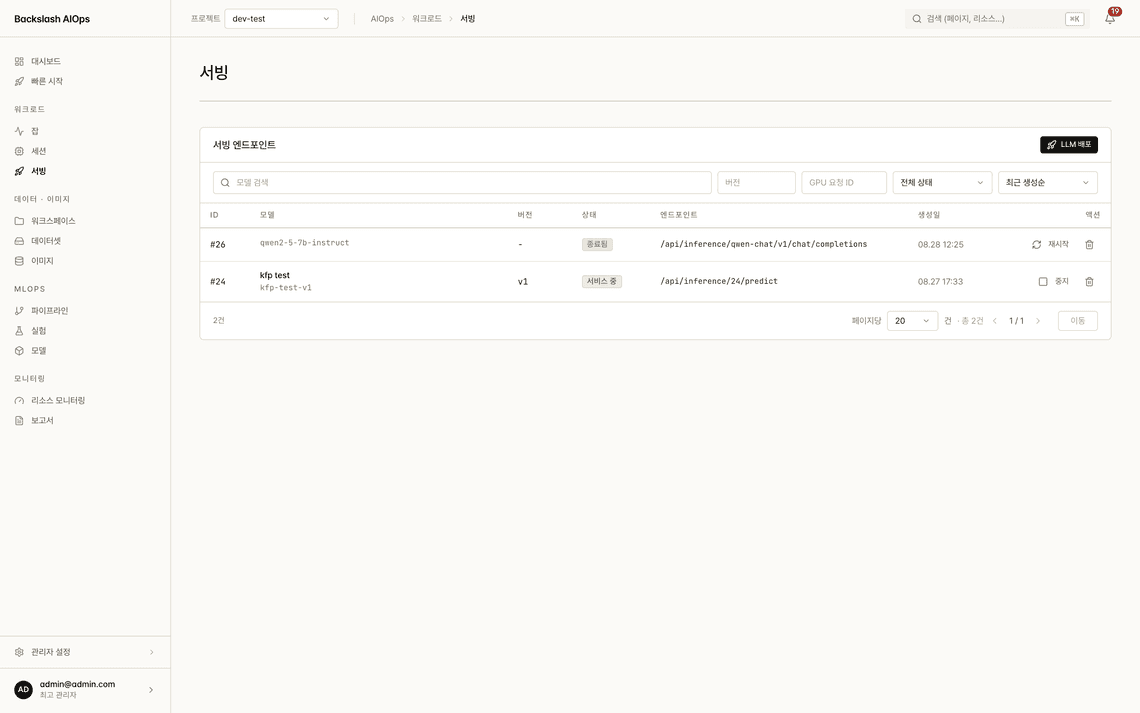
  • 학습이 성공하면 모델 버전이 자동 등록(검토 대기)
  • 검토 대기 → 승인 → 배포 → 폐기 단일 게이트 라이프사이클
  • 승인되지 않은 모델은 배포할 수 없다 — 플랫폼이 막는다
  • KServe 배포와 함께 REST 엔드포인트를 자동 생성
모델 버전 상태와 서빙 엔드포인트를 보여주는 Backslash AIOps 모델 화면12
  1. 1REST 엔드포인트 자동 생성
  2. 2KServe로 원클릭 배포

모니터링 및 운영

자원과 워크로드를 함께 보는

모니터링과 알림

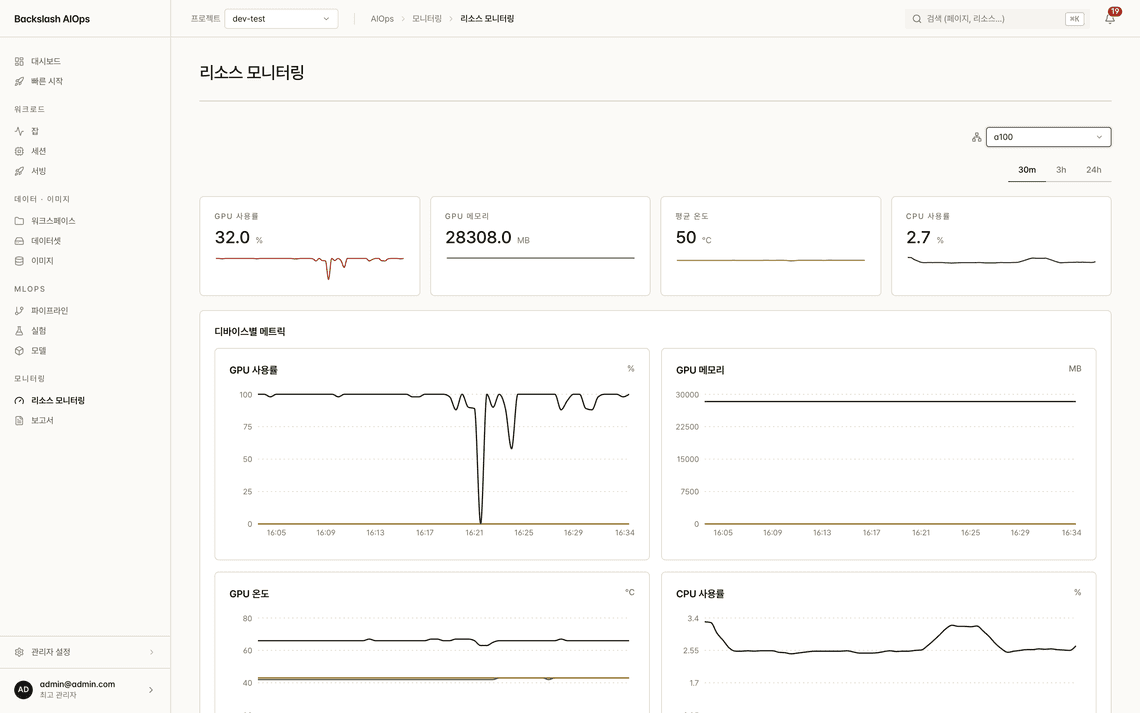
  • GPU 사용률 · 메모리 · 온도를 노드와 잡 단위로 조회
  • DCGM Exporter · Prometheus 기반 실측 지표
  • 임계값 기반 알림 규칙을 화면에서 정의하고 웹 · 푸시 · 웹훅으로 전달
  • GPU 사용 실적을 PDF · Excel · CSV · JSON 보고서로 내보내기
GPU 사용률·메모리·온도 그래프를 보여주는 Backslash AIOps 리소스 모니터링 화면12
  1. 1DCGM 실측 지표
  2. 2노드 · 잡 단위로 조회

인프라 관리

한 줄 명령으로 붙이는

클러스터 · 노드 등록

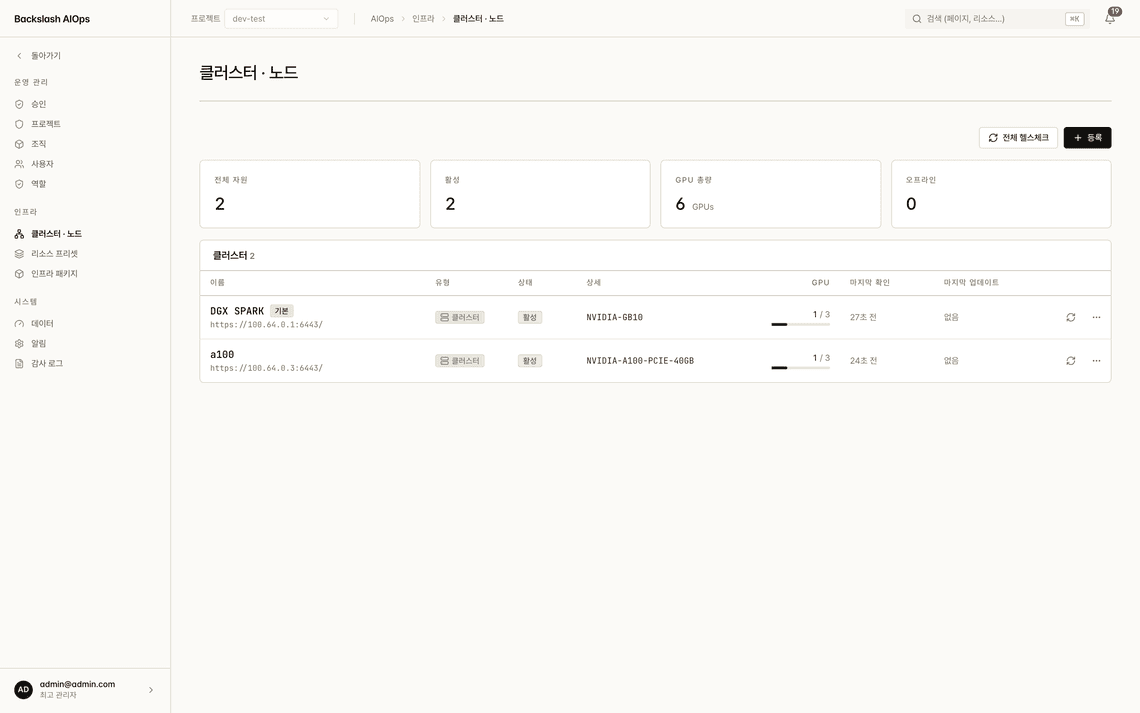
  • 마법사가 만들어 준 한 줄 설치 명령으로 노드를 등록
  • 원격 클러스터는 커넥터 에이전트로 연결 — 여러 클러스터를 한 화면에서
  • 폐쇄망(Air-gapped) 설치를 위한 이미지 번들을 플랫폼이 직접 공급
  • 인프라 패키지의 업그레이드와 롤백을 화면에서 수행
등록된 클러스터와 GPU 현황을 보여주는 Backslash AIOps 클러스터 · 노드 화면12
  1. 1한 줄 명령으로 노드 등록
  2. 2여러 클러스터를 한 화면에서

보안 및 감사

통제하고 기록하는

접근 권한과 감사 로그

  • OIDC 표준 SSO — issuer 디스커버리로 사내 IdP에 연결
  • 2단계 인증(TOTP)과 자동화용 개인 액세스 토큰(PAT) 지원
  • 역할별 권한을 세분화해 메뉴와 API 접근을 함께 통제
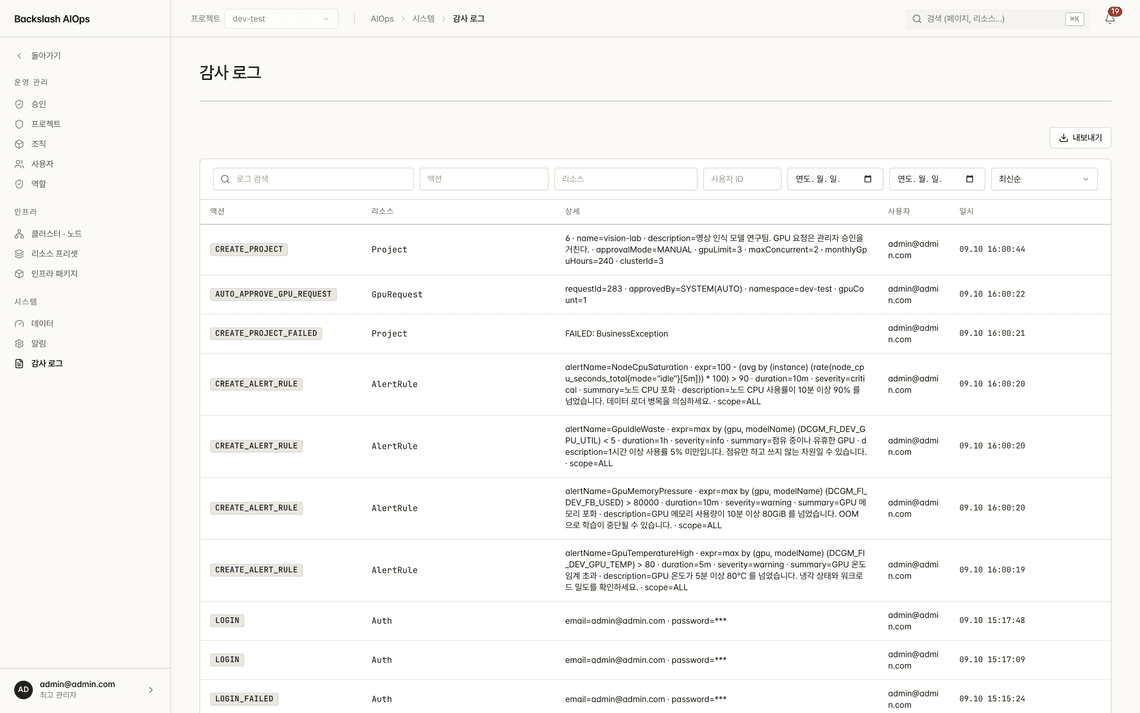
  • 로그인 · 자원 요청 · 승인 · 설정 변경을 전량 기록하고 내보내기
작업·리소스·사용자·일시가 기록된 Backslash AIOps 감사 로그 화면12
  1. 1누가 · 무엇을 · 언제
  2. 2감사 대응용 내려받기

도입 환경

고객의 망과 장비를 있는 그대로 받아들입니다.

인터넷이 없어도, 클러스터가 여러 개여도, GPU 모델이 서로 달라도 같은 방식으로 운영합니다.

  1. 01

    온프레미스

    고객 데이터센터의 GPU 서버에 직접 설치. 데이터가 외부로 나가지 않습니다.

  2. 02

    폐쇄망 (Air-gapped)

    인터넷 연결 없이 설치·운영. 설치 스크립트와 이미지 번들을 플랫폼이 공급합니다.

  3. 03

    멀티 클러스터

    원격 클러스터를 커넥터 에이전트로 연결해 한 화면에서 함께 운영합니다.

  4. 04

    이기종 GPU

    A100 · H100 · H200 · B200 · B300과 DGX Spark(GB10, aarch64)까지, 서로 다른 NVIDIA GPU 장비를 같은 방식으로 운영합니다.

검증된 오픈소스 위에 올렸습니다

  • Kubernetes
  • HAMi vGPU
  • NVIDIA GPU Operator
  • DCGM
  • Argo Workflows
  • KServe
  • MLflow
  • Prometheus · Grafana
  • Spring Boot
  • Next.js

FAQ

자주 묻는 질문

Backslash AIOps는 어떤 솔루션인가요?

Backslash AIOps는 Kubernetes 위에서 GPU 자원의 신청·승인·분할·회수를 관리하고, 그 위에서 학습부터 서빙까지 AI 라이프사이클 전체를 운영하는 플랫폼입니다.

GPU 한 장을 여러 사용자가 나눠 쓸 수 있나요?

네. Time-slicing·MPS·MIG 세 가지 분할 모드를 화면에서 전환할 수 있고, HAMi 기반 vGPU로 GPU 메모리·연산 지분을 분리 할당합니다. 분할 수는 설정값이 아니라 노드 실측에서 유도해 화면과 실제가 어긋나지 않습니다.

인터넷이 연결되지 않은 폐쇄망에도 설치할 수 있나요?

네. 인터넷 연결 없이 설치·운영할 수 있도록 설치 스크립트와 이미지 번들을 플랫폼이 직접 공급하고, 한 줄 명령으로 노드와 클러스터를 등록합니다.

GPU가 부족하면 요청이 거부되나요?

아니요. 자원이 부족하면 요청을 거부하지 않고 대기(QUEUED) 상태로 두고, 자리가 나면 클러스터에 설정한 정책(FIFO·LIFO·FAIR·DRF)에 따라 자동으로 실행합니다.

어떤 GPU 장비에서 운영할 수 있나요?

A100, H100, H200, B200, B300 등 NVIDIA GPU를 모두 지원하며, DGX Spark(GB10, aarch64)까지 서로 다른 장비를 같은 방식으로 운영합니다. 온프레미스 데이터센터와 여러 클러스터 환경도 지원합니다.

Backslash AIOps 도입을 검토하고 계신가요?

보유한 GPU 장비와 망 환경을 알려주시면 도입 방법을 함께 검토해 드립니다.

\ BACKSLASH \

대표자: 송주현 | 사업자등록번호 : 787-81-02609
서울 지사 : 서울특별시 금천구 가산디지털1로 120, 702호
기업부설연구소 : 경남 양산시 물금읍 부산대학로 16, 204호
부산 지사 : 부산광역시 북구 효열로 76-1, 204호
대구 지사 : 대구광역시 북구 칠성남로38길 56, 3층 307호
고객상담 : 1555-2440 (평일 10시~18시) | 이메일 : contact@backslash.co.kr
산업디자인전문회사 신고 제 18330호

© 2026 BackslashPartners Co., Ltd. All right reserved.